前言
笔者在学习强化学习过程中的笔记整理汇总如下. 学习资料主要来自西湖大学赵世钰老师的强化学习的数学原理系列课程, 是非常高质量的课程, 强烈推荐.
由于该篇文章主要聚焦在笔者对赵老师课程的浅薄理解, 因此内容忽略部分内容, 包括部分证明以及定义等, 感兴趣的读者可以自行进行阅读.
目录
不定时更新…
符号定义 (Notation)
我们站在马尔科夫决策过程 (Markov Decision Process) 的框架下, 给出下述定义以及性质. 下述概念中,
- “Markov” 对应 “无记忆性/Memoryless property”
- “Decision” 对应 “策略/Policy”
- “Process” 理解为: 状态之间的跳转, 因此对应 “状态, 动作, 转移概率”
| 数学定义 | 直观理解 | 含义 |
|---|---|---|
| $ s $ | 状态/State | |
| $ S=\lbrace s_i \rbrace_{i=1}^{N_{s}} $ | 状态空间/State Space | |
| $a$ | 动作/Action | |
| $ A(s_i)=\lbrace a_i \rbrace_{i=1}^{N_{a}} $ | 在状态 $s_i$ 下有 $N_a$ 个状态 | 状态 $s_i$ 的动作空间/Action Space of State |
| $p(s_{next}|s_{current}, a_i) \in [0, 1]$ | Agent 在当前状态, 采取动作 $a_i$ 会到状态 $s_{next}$ 的概率 | 状态转移概率/State transition probability |
| $\pi(a_i|s_{current}) \in [0, 1], \forall i \in [1, N_a]$ | Agent 在当前状态, 采取动作 $a_i$ 的概率 | 策略/Policy |
| $p(r=?|s_{current}, a_{current}) \in [0, 1]$ | Agent 选择一个动作之后得到的一个人为设定的实数 “?” 的概率 | 奖励/Reward |
| $s_{t_1}\xrightarrow{a_{t_1}}\dots r_{t_{n-1}}, s_{t_n}\xrightarrow{a_{t_n}} r_{t_n}, s_{target}$ | Agent 实现目标的一系列 $\lbrace state, action \rbrace$ pair | 路径/尝试/Trajectory/trail/episode |
| $\sum_{i=1}^{n} r_{t_i}$ | Agent 沿着 一条 trajectory 得到的 reward 总和 | Return |
| $\sum_{i=1}^{n} \gamma^{i-1} r_{t_i}, \gamma\in (0, 1)$ | 逐渐衰减的 return; 控制 $\gamma$ 能够控制 policy 的远/近视 | Discounted Return |
无记忆性/Memoryless property \(p(s_{t+1}|a_{t+1}, s_{t} \dots, a_1, s_0) = p(s_{t+1}|a_{t+1}, s_{t}) \\ p(r_{t+1}|a_{t+1}, s_{t} \dots, a_1, s_0) = p(r_{t+1}|a_{t+1}, s_{t})\)
贝尔曼公式
State Value Definition
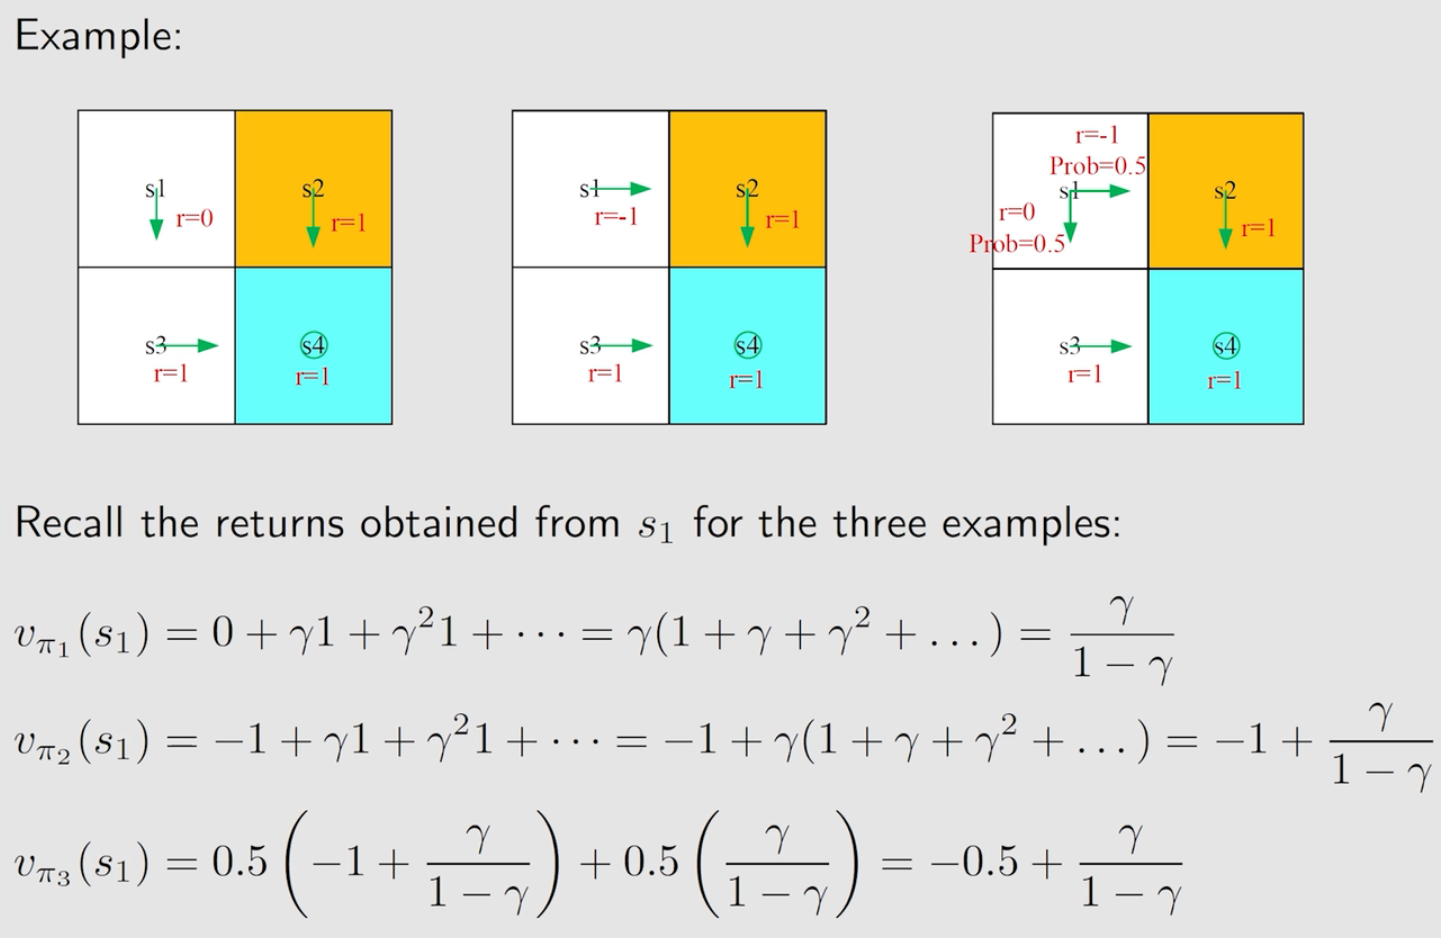
Discounted Return 能够反映出策略的 “好/坏”. 给出 Trajectory: $\textcolor{gray}{R_t,}S_{t}\xrightarrow{A_{t}} R_{t+1}, S_{t+1}\xrightarrow{A_{t+2}} R_{t+3}, S_{t+3}\dots$, 首先可以计算得到其对应的 discounted return 为:
\(\begin{align} G_t=R_{t}+\gamma^2 R_{t+1}+\gamma^3 R_{t+2}+\dots, \end{align}\) 其中, $S, A, R$ 均为随机变量 (所以大写). $t, \gamma\in[0, 1)$ 分别表示时间步和 discount rate. 不难知道, $G_t$ 也为随机变量. 在相同任务设置且策略是确定性策略时, trajectory 也是确定性的. 此时有: discounted return 越大, 策略越优.
但是确定性策略应用范围有限, 更广泛使用的是随机性的策略, 即: 从状态 $s$ 出发, 有 $\pi(a_1\mid s)$ 概率采取行动 $a_1$; 有 $\pi(a_2\mid s)$ 概率采取行动 $a_2$. 此时自然对应着: 一个状态出发可能有多条 trajectory, 进而会得到多个 (discounted) return. 选取任一 trajectory 的 discounted return 描述当前状态的 “好/坏” 都有失公允, 因此定义 State Value:
\(\begin{align} v_{\pi}(s)=\mathbb{E}[G_t\mid S_t=s], \end{align}\) 其中, $v_{\pi}(s)=v(s, \pi)$ 是一个关于 $s, \pi$ 的函数. 经过上述分析, 同理得到: State value 越大, 策略越优.
贝尔曼公式 (Bellman Equation, BE)
我们刚才得到了非常有意义的概念: state value. 那么怎么计算呢? 靠贝尔曼公式计算. 接下来笔者进行贝尔曼公式的推导. 我们前面得到:
\[\begin{align} G_t &=R_{t+1}+\gamma^2 R_{t+1}+\gamma^3 R_{t+1}+\dots \\ &=R_{t+1}+\gamma(\underbrace{\gamma R_{t+1}+\gamma^2 R_{t+1}+\dots}_{G_{t+1}})\\ &=R_{t+1}+\gamma G_{t+1}. \\ \end{align}\]将上述式子代入到 state value 的定义中, 可得:
\[\begin{align} v_{\pi}(s) &=\mathbb{E}[G_t\mid S_t=s] \\ &=\mathbb{E}[R_{t+1}+\gamma G_{t+1}\mid S_t=s] \\ &=\underbrace{\mathbb{E}[R_{t+1}\mid S_t=s]}_{第一项} + \gamma \underbrace{\mathbb{E}[G_{t+1}\mid S_t=s]}_{第二项}. \\ \end{align}\]第一项
\(\begin{align} \mathbb{E}[R_{t+1}\mid S_t=s] &= \sum_a \pi(a\mid s) \mathbb{E}[R_{t+1}\mid S_t=s, A_t=a] \\ &= \sum_a \pi(a\mid s) \sum_r p(r\mid s, a) r, \\ \end{align}\)
- 第一个等号是因为: 虽然状态 $s$ 固定, 但是要执行的动作 $A_t$ 是随机变量, 是 stochastic policy. 因此 $R_{t+1}$ 的期望还要固定下 $A_t=a$.
- 第二个等号是利用了期望算子的定义 $\mathbb{E}(X)=\sum_x p(x)\cdot x$.
这一项表示了 immediate reward 的平均值.
第二项
\[\begin{align} \mathbb{E}[G_{t+1}\mid S_t=s] &=\sum_{s'} p(s'\mid s)\cdot \mathbb{E}[G_{t+1}\mid S_t=s, S_{t+1}=s'] \\ &=\sum_{s'} p(s'\mid s)\cdot \mathbb{E}[G_{t+1}\mid S_{t+1}=s'] \\ &=\sum_{s'} p(s'\mid s)\cdot v_{\pi}(s') \\ &=\sum_{s'} \left(\sum_a p(s'\mid s, a) \pi(a\mid s) \right) v_{\pi}(s') \\ &=\sum_{s'} v_{\pi}(s') \sum_a p(s'\mid s, a) \pi(a\mid s), \\ \end{align}\]
- 第一个等号是因为: 等号左边稍微 “错位”, 因此引入 $t+1$ 时刻的 state $S_{t+1}$ 和 $G_{t+1}$ 相匹配;
- 第一个等号是因为: 马尔科夫决策过程的 “无记忆性”;
- 第三个等号利用了 state value 的定义;
- 第四个等号是因为: 全概率公式: $p(y) = \sum_x p(y\mid x) p(x)$;
这一项表示了 future reward 的平均值.
如上, 分别分析两项之后可得
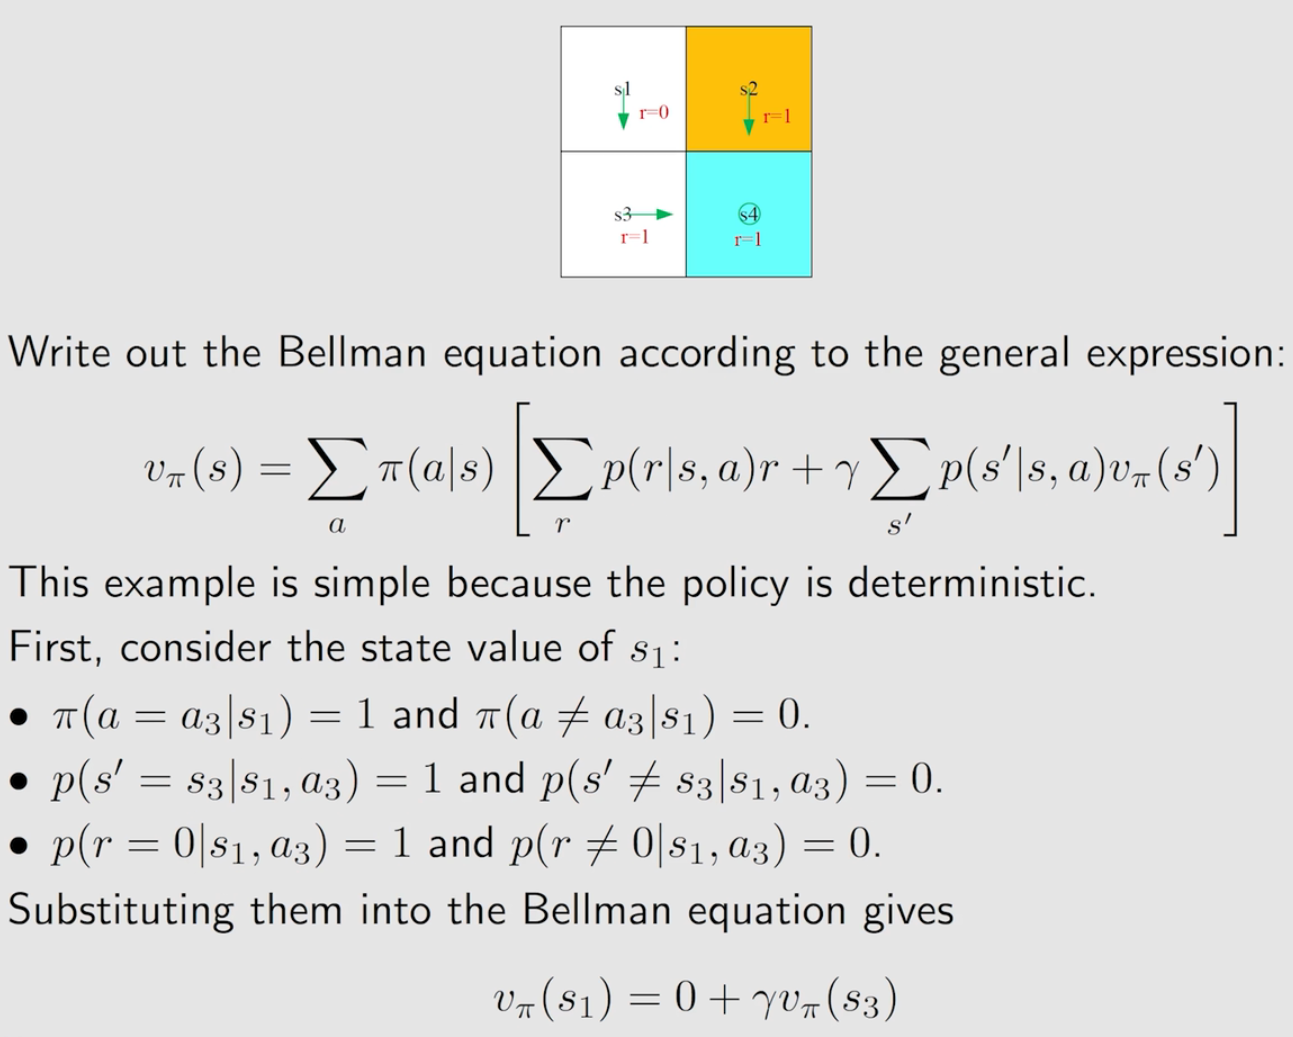
\[\begin{align} v_{\pi}(s) &=\sum_a \pi(a\mid s) \sum_r p(r\mid s, a) r + \gamma \sum_{s'} v_{\pi}(s') \sum_a p(s'\mid s, a) \pi(a\mid s) \\ &=\sum_a \pi(a\mid s) \Bigl[\sum_r p(r\mid s, a) r + \gamma \sum_{s'} v_{\pi}(s') p(s'\mid s, a) \Bigr], \forall s\in S. \\ \end{align}\]上述式子就是贝尔曼公式! 需要注意的是, 因为 $\forall s\in S$, 所以贝尔曼公式通常是 “一组” 的; 这也给我们求解提供了可能性.
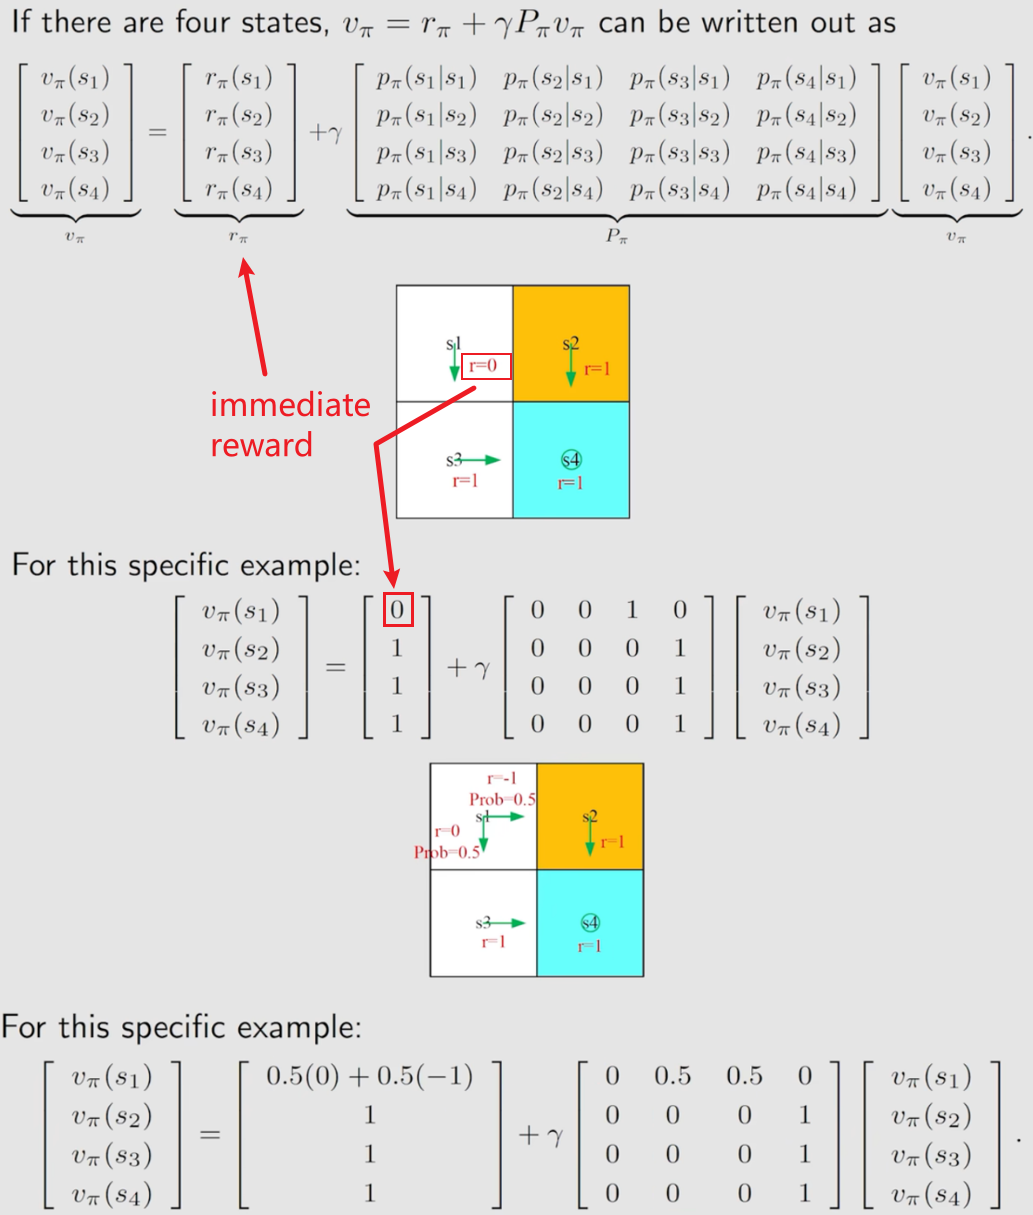
也正是因为贝尔曼公式是 “一组” 的, 因此我们可以写成矩阵形式. 我们首先重写 element-wise form:
\[\begin{align} v_{\pi}(s) &=\underbrace{\sum_a \pi(a\mid s) \sum_r p(r\mid s, a) r}_{r_{\pi}(s)} + \gamma \sum_{s'} v_{\pi}(s') \underbrace{\sum_a p(s'\mid s, a) \pi(a\mid s)}_{p_\pi(s'\mid s)} \\ &= r_{\pi}(s) + \gamma \sum_{s'} v_{\pi}(s')p_\pi(s'\mid s). \\ \end{align}\]由于是一组贝尔曼公式, 我们赋以下标进行区分:
\[\begin{align} v_{\pi}(s_i) = r_{\pi}(s_i) + \gamma \sum_{s_j} v_{\pi}(s_j)p_\pi(s_j\mid s_i). \\ \end{align}\]最终可得 matrix-form: \(\begin{align} v_{\pi} = r_{\pi} + \gamma P_\pi v_{\pi}, \\ \end{align}\) 其中, $v_{\pi} = \left[ v_{\pi}(s_1), \ldots, v_{\pi}(s_n) \right]^T \in \mathbb{R}^n$; $r_{\pi} = \left[ r_{\pi}(s_1), \ldots, r_{\pi}(s_n) \right]^{\top} \in \mathbb{R}^n$; $P_{\pi} \in \mathbb{R}^{n \times n}$, 其中 $\left[P_{\pi}\right]{ij} = p{\pi}(s_j \mid s_i)$ 是状态转移矩阵 (state transition matrix).
显然, 贝尔曼公式的闭式解为:
\[\begin{align} v_{\pi} = (I-\gamma P_\pi)^{-1} r_{\pi}. \\ \end{align}\]然而闭式解费时费力, 不好用! 我们更常用到的是迭代式求解.
\[\begin{align} v_{k+1} = r_{\pi} + \gamma P_\pi v_{k}, \\ \end{align}\]当迭代次数 $k\to \infty$, 有 $v_{k}\to (I-\gamma P_\pi)^{-1} r_{\pi}$ 成立. 具体证明过程见【强化学习的数学原理】课程的 10:13 处.
Action Value Definition
现在我们手头上有了一件称心如意的工具: 贝尔曼公式, 其能够帮助我们评估状态 $s$ 的价值. 然而, 只评估出状态的价值并不能够帮助我们去改进策略. 而策略又和每个状态所选取的动作紧密相关, 因此我们需要知道在每个状态下的每个动作的价值. 因此引出了该小节的内容—— Action Value.
举个例子, 我们知道学习工作达到心流状态的 “价值” 很高; 但是达到心流状态有多种动作可供选择: 冥想, 听纯音乐, 拉伸等. 我们应该选择哪些动作呢? 如果能评估出, “冥想” 有 1 分; “听纯音乐” 有 2 分; “拉伸” 有 3 分. 我们就可以根据动作来修正策略——即:优先级为:拉伸 $>$ 听音乐 $>$ 冥想.
定义 Action Value
\[\begin{align} q_{\pi}(s, a)=\mathbb{E}[G_t\mid S_t=s, A_t=a]. \end{align}\]从朴素直觉出发, 有: state value 是所有可能的 action value 的加权平均, 也就是:
\[\begin{align} \underbrace{\mathbb{E}[G_t\mid S_t=s]}_{\textcolor{red}{v_{\pi}(s)}} = \sum_a \underbrace{\mathbb{E}\left[G_t \mid S_t=s, A_t=a\right]}_{\textcolor{red}{q_{\pi}(s, a)}} \pi(a\mid s). \end{align}\]又因为我们已经推导得: $v_{\pi}(s) = \sum_a \pi(a\mid s) \Bigl[\sum_r p(r\mid s, a) r + \gamma \sum_{s’} v_{\pi}(s’) p(s’\mid s, a) \Bigr]$. 所以对照上式可得:
\[\begin{align} \textcolor{red}{q_{\pi}(s, a)} = \sum_r p(r\mid s, a) r + \gamma \sum_{s'} \textcolor{red}{v_{\pi}(s')} p(s'\mid s, a). \end{align}\]上述两个式子均刻画了 state value $\textcolor{red}{v_{\pi}(s)}$ 和 action value $\textcolor{red}{q_{\pi}(s, a)}$ 二者之间的关联.
现在我们在知道 state value 的基础上, 可以进一步计算得到 action value; 这能够有效地帮助我们在状态 $s$ 下找到最佳的动作 $a^\star$. 形式化表达为: $a^\star = \arg \max_a q_{\pi}(s,a)$. 此时, 策略可以进行更新:
\[\begin{align} \pi(a\mid s) = \begin{cases} 1 \ a=a^\star \\ 0 \ a\neq a^\star \\ \end{cases} \end{align}\]现在我们已经了解策略更新的大致方式, 但是更新过程中, 是逐渐逼近最优策略? 还是一步到位? 状态 $s$ 处的更新是否依赖其他状态的策略已经达到最优呢?
对上述问题的解答需要依赖于数学, 具体来说,是依赖接下来要讲的: 贝尔曼最优公式.
贝尔曼最优公式 (BOE)
最优策略定义
在引入贝尔曼最优公式之前, 我们需要将 “最优策略” 这个分析对象用数学语言进行翻译.
我们认为策略 $\pi_1$ 优于 $\pi_2$ 若 $\forall s\in S$, 有: $v_{\pi_1}(s)\geq v_{\pi_2}(s)$ 成立. 进而我们可以定义出 “最优策略”.
\[\begin{align} v_{\pi^*}(s)\geq v_{\pi}(s), \forall s\in S, \pi. \end{align}\]上述 “最优策略” 的定义是自然直观的, 但是伴随着定义出现众多问题: 存在性, 唯一性, 确定性, 操作性.
幸运的是, 我们有工具可以研究上述问题——贝尔曼最优公式.
贝尔曼最优公式 (BOE)
接下来我们直接给出 BOE. 顾名思义, BOE 和贝尔曼公式 (BE) 有千丝万缕的关联. 其也可以写成两种形式如下, 分别是 element-wise 和 matrix-vector form. \(\begin{align} v(s) &=\textcolor{red}{\max_{\pi}} \underbrace{\sum_a \pi(a\mid s) \Bigl[\sum_r p(r\mid s, a) r + \gamma \sum_{s'} v(s') p(s'\mid s, a) \Bigr]}_{\text{非常显然, 这里就是 state value: } v_{\pi}(s)}, \forall s\in S. \\ &=\textcolor{red}{\max_{\pi}} \sum_a \pi(a\mid s) q(s,a), \forall s\in S. \\ v &= \textcolor{red}{\max_{\pi}}(r_{\pi} + \gamma P_{\pi} v) \end{align}\)
其中, $p(r\mid s, a), r, \gamma, p(s’\mid s, a)$ 均是已知的. 且有:
\[\begin{aligned} \left[r_{\pi}\right]_{s} &\triangleq \sum_{a} \pi(a \mid s) \sum_{r} p(r \mid s, a) \, r, \\ \left[P_{\pi}\right]_{s, s'} &= p(s' \mid s) \triangleq \sum_{a} \pi(a \mid s) \sum_{s'} p(s' \mid s, a). \end{aligned}\]不难发现, BOE 和 BE 其实就差了个$\textcolor{red}{针对每个元素的 \max_\pi}$ 操作. 形式化表达: $\max_\pi (BE_1, \dots, BE_n)^{\top}=(\max_\pi BE_1, \dots, \max_\pi BE_n)^{\top}$.
怎么求解 BOE 呢?
- 我们首先给 $v(s’)$ 赋以初始值; 又因为 $p(r\mid s, a), r, \gamma, p(s’\mid s, a)$ 均已知, 因此有 $q(s,a)$ 已知. 此时 BOE 的 objective function 仅有 $\pi(a\mid s)$ 是未知量.
- 由于一个状态具有多个动作 $a$, 因此对应的 $q(s, a)$ 也是有多个. 如何求解 $\max_\pi \sum_a \pi(a\mid s) q(s,a)$ 呢? 参照下图所示的例子进行求解可得:
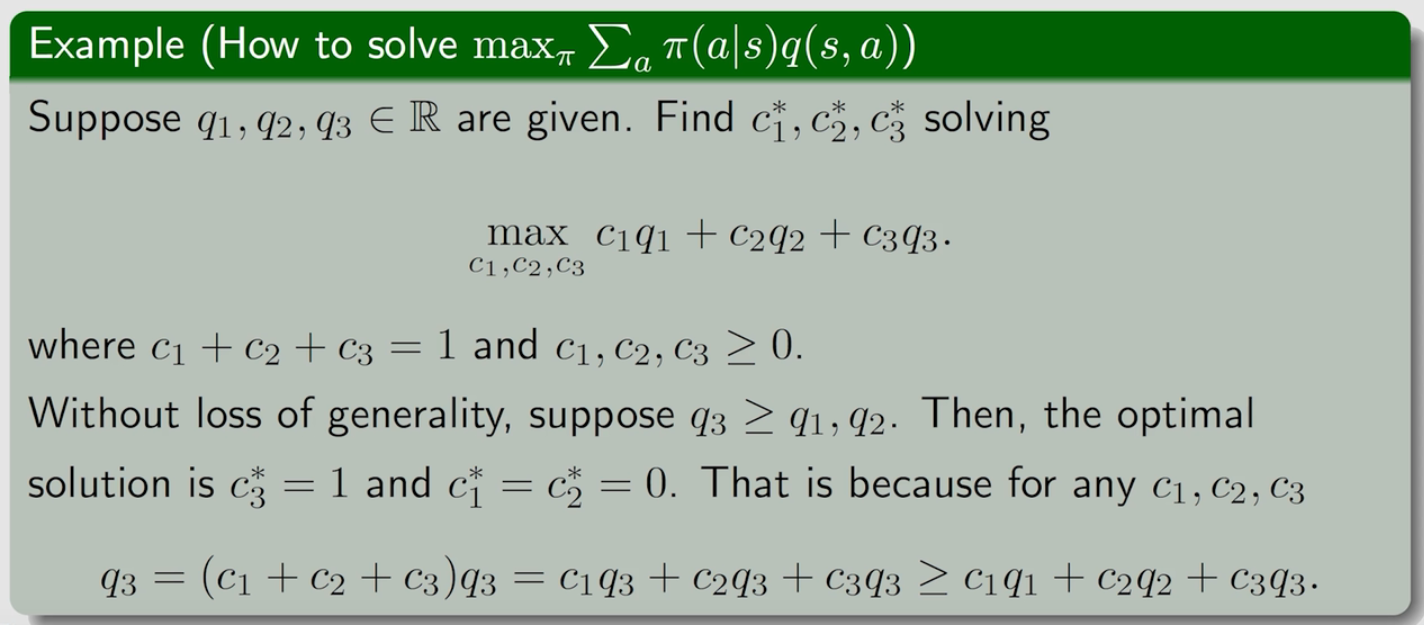
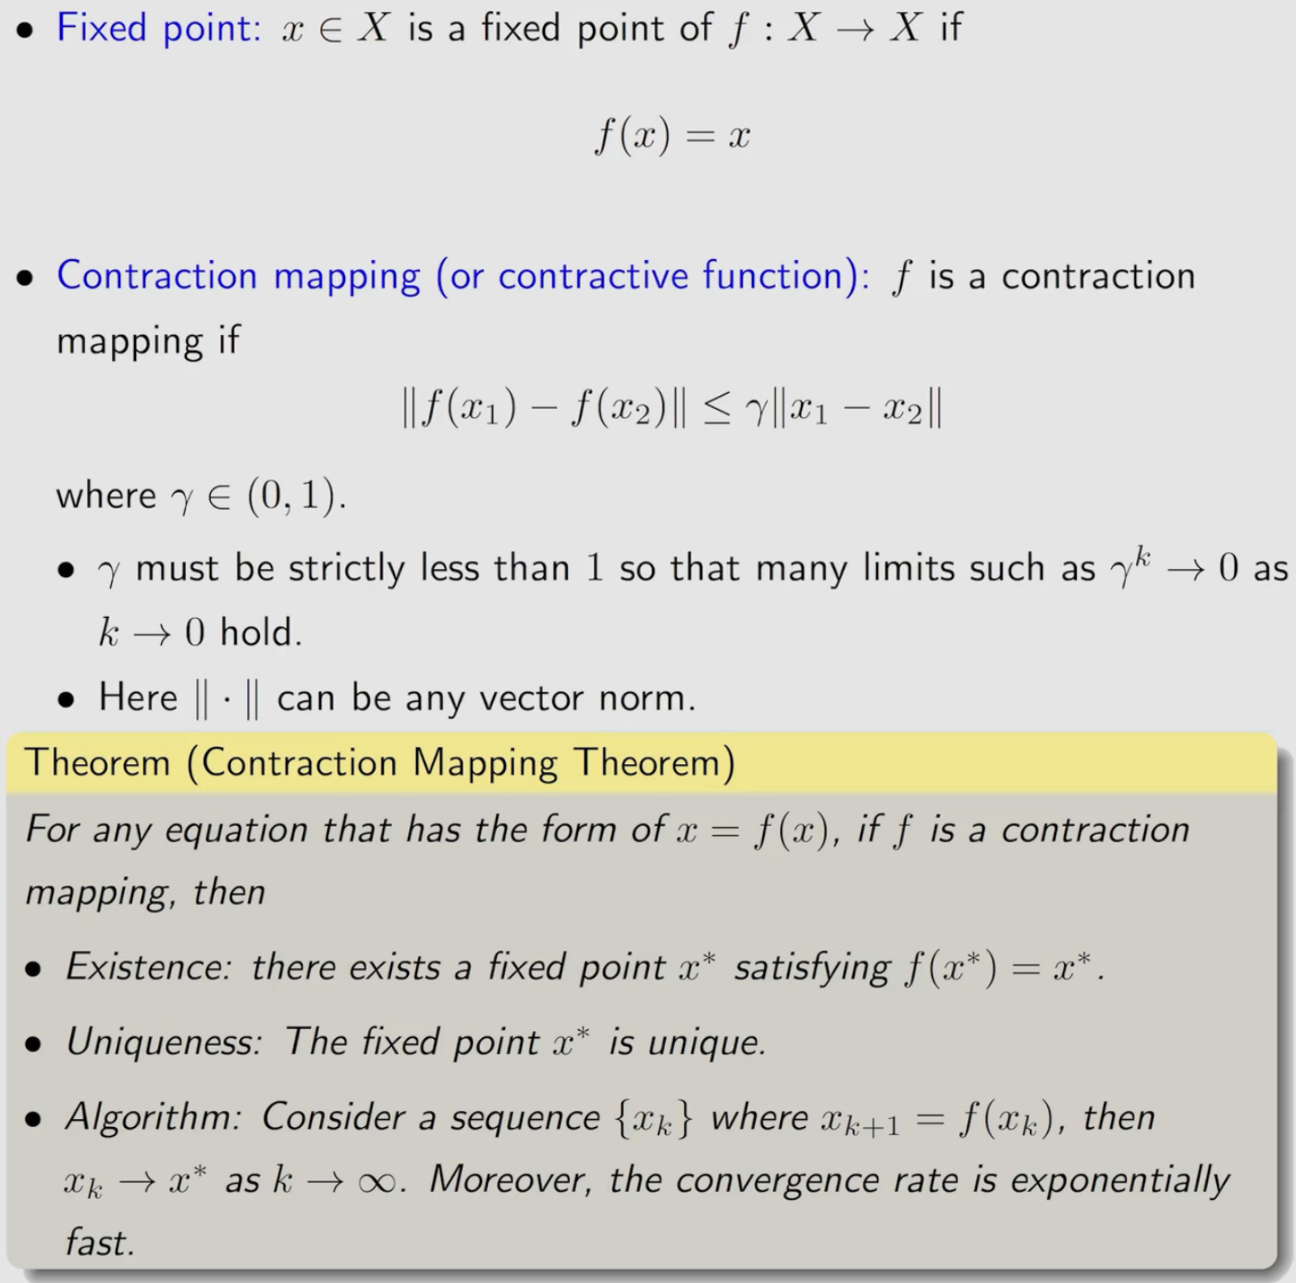
- 由前面两个步骤可得, $\max_\pi (r_{\pi} + \gamma P_{\pi} v)$ 的求解过程是先给定 (固定) $v$ 然后求出对应的 $\pi$. 因此我们不妨定义 $f(v)\triangleq \max_\pi (r_{\pi} + \gamma P_{\pi} v)$. 所以 BOE 可以简化为: \(\begin{align} v &= f(v), \\ \text{其中, } [f(v)]_{s} &= \max_{\pi} \sum_{a} \pi(a\mid s) q(s,a), s\in S \end{align}\) 这里的形式很自然让人联想到数学中的 “不动点”. 针对 (简化后的) BOE: $v=f(v)$, 我们首先可证, $f(v)$ 是 contraction mapping; 然后利用 contraction mapping theorem 可得: $v^{\star}$ 的存在性以及唯一性. 此外, 我们还知道如何求解出 $v^{\star}$: 迭代求解! 并且收敛性也得到了保证. \(\begin{align} v_{k+1} = f(v_{k}) = \max_\pi (r_{\pi} + \gamma P_{\pi} v_k). \end{align}\)
学习资料
[1] 强化学习的数学原理